


IA local o en la nube, cuándo compensa usar tu propio ordenador
El contrato del cliente ya está en la ventana de subida y el cursor, sobre «Enviar». Justo en ese momento muchos dudan, y con razón: todo lo que escribes o subes a un chatbot en la nube acaba en los servidores del proveedor. La IA local mantiene los datos en casa, aunque a cambio necesita el hardware adecuado. Hemos analizado siete tareas reales del día a día para ver qué conviene hacer en tu propio ordenador, qué funciona mejor en la nube y cuándo compensa combinar ambas.
Tres formas de usar la IA
«¿IA local o en la nube?» casi nunca tiene una respuesta tajante. Es más útil fijarse en dos cosas: dónde trabaja el modelo y adónde van tus datos.
1. Agente de IA. Un agente es un programa que planifica sus propios pasos y maneja herramientas como el navegador o el correo. Agentes como OpenClaw o Hermes Agent, de Nous Research, funcionan día y noche en un equipo pequeño y de bajo consumo. Pero el razonamiento ocurre en otro sitio: el agente envía sus peticiones a un modelo en la nube a través de una interfaz de programación (API).
2. Nube + local. El ordenador se encarga de lo cotidiano, como los subtítulos en directo, la supresión de ruido o modelos de lenguaje pequeños, y lo más exigente se envía a ChatGPT, Claude o Gemini. Así trabajan hoy la mayoría de las oficinas, muchas veces sin haberlo planeado.
3. Totalmente local. Los modelos abiertos, es decir, archivos de modelo que se pueden descargar libremente (open weights), funcionan por completo en tu ordenador. Entre ellos están Qwen, Gemma, gpt-oss o Mistral. Herramientas como Ollama, LM Studio o llama.cpp cargan el modelo y lo dejan listo para usar, incluso sin conexión a internet.
Qwen, de Alibaba, muestra lo difusa que puede ser la frontera. Si usas Qwen Chat en el navegador, tus mensajes se envían, según su política de privacidad, a servidores en Singapur. En cambio, Qwen3.8-27B, un modelo abierto de la misma familia, se puede descargar y ejecutar sin conexión. Misma familia de modelos, pero un camino totalmente distinto para tus datos.
Siete tareas habituales de IA y dónde funcionan mejor
Todos los ejemplos salen del día a día de cualquier empresa u oficina. En cada caso hemos valorado la protección de datos, la velocidad, el coste, si funciona sin conexión y la calidad que necesita el modelo. El tamaño del modelo se indica con «B», de miles de millones (billions) de parámetros, es decir, los pesos que el modelo ha aprendido durante el entrenamiento.
Un agente de IA que trabaja de noche
Una tienda online revisa cada noche las webs de 30 competidores. El agente apunta precios y productos nuevos y, a las 7 de la mañana, deja un resumen en el correo. Funciona en un equipo propio de bajo consumo, aislado de los archivos personales y las contraseñas (sandbox).
Lo que cuenta aquí es que funcione sin parar, que consuma poco y que el modelo entienda bien webs complejas. Por eso el razonamiento lo pone un modelo en la nube, como GPT-6, Claude Sonnet 5.5 o Gemini 4. Los proveedores no publican cuántos parámetros tienen.
Para el equipo eso apenas importa, porque solo envía peticiones y recibe respuestas. La lógica del proceso, los registros y las credenciales se quedan en casa, y a la nube solo llega lo que el agente está analizando en ese momento. La AEPD ha publicado un decálogo para delegar tareas en asistentes y agentes de IA con recomendaciones útiles para este tipo de uso.
Nuestra recomendación: combinar ambas
Despacho de abogados o asesoría: consultar expedientes sin subir nada
«¿Cuáles de nuestros 500 contratos con proveedores se renuevan antes de marzo?» No es una pregunta que quieras hacerle a un chatbot público, y en una asesoría o un despacho tampoco se debe sin más. Los expedientes de los clientes están protegidos por el secreto profesional (cuya revelación castiga el artículo 199 del Código Penal) y por el RGPD.
La técnica adecuada se llama RAG (Retrieval-Augmented Generation). El sistema busca primero en los documentos propios y solo pasa al modelo los fragmentos relevantes, en los que basa su respuesta.
En local basta con un modelo de 27B a 31B, como Gemma 4 31B o Qwen3.8-27B. Para archivos muy grandes, gpt-oss-120b (117B parámetros) ofrece más margen. Cada respuesta indica de dónde sale la información, con número de página, y todo funciona incluso con la conexión de red cortada.
Nuestra recomendación: local
Consulta médica y terapia: transcribir conversaciones en local
Una consulta de atención primaria graba las conversaciones, siempre con el consentimiento de los pacientes. El sistema de reconocimiento de voz Whisper, de OpenAI, las convierte en texto, y un modelo de lenguaje local redacta la entrada para la historia clínica. La médica solo tiene que revisarla y completarla.
Los datos de salud forman parte de las categorías especiales de datos personales del artículo 9 del RGPD, con normas muy estrictas, y a eso se suma el secreto médico. Cualquier servicio en la nube exigiría un análisis legal a fondo. Si todo funciona en local, los datos no salen de la consulta.
Para el resumen basta un modelo de 27B a 35B, por ejemplo Qwen3.8-27B o Muse Glimmer, el modelo abierto de Meta, con casi 30B. Whisper es relativamente ligero: su variante turbo tiene 809 millones de parámetros.
Nuestra recomendación: local
Un asistente de IA para todo el equipo
Un fabricante de maquinaria con 25 empleados quiere que todos encuentren rápido respuestas en manuales, instrucciones de control y normas internas. Para ello, un ordenador central en la red de la empresa ejecuta un modelo local. Se usa a través de Open WebUI, una interfaz de chat en el navegador que se conecta con Ollama.
Según la RAM disponible, encajan Qwen3.6-35B-A3B, Nemotron 3.5 Lightning con 30B o gpt-oss-120b. Los dos primeros solo calculan con 3B parámetros activos por token, es decir, por fragmento de palabra. Eso acelera mucho las respuestas; más adelante, en el apartado de la RAM, explicamos por qué.
El modelo no tiene licencias por usuario y los datos de los clientes no salen de la empresa. Para alguna consulta muy especializada se puede mantener, además, un acceso a la nube.
Nuestra recomendación: local, con apoyo de la nube si hace falta
Un agente de programación sin límites de uso
Un agente de programación lee un repositorio completo, planifica cambios y escribe código y pruebas. Quien lo usa a fondo choca enseguida, en los servicios en la nube, con cuotas y límites de peticiones por periodo. Un modelo de lenguaje (LLM) que funciona en local no necesita clave de API ni tiene esos límites.
Funcionan bien Qwen3.8-27B, con una ventana de contexto de 262.144 tokens, o GLM-4.7-Flash, de Z.ai, con 30B parámetros, de los que 3B están activos. La ventana de contexto determina cuánto texto tiene en cuenta el modelo a la vez. Para bases de código grandes conviene que sea de 131.000 tokens o más.
En las tareas más difíciles, los modelos en la nube como Claude Opus 5.5 o GPT-6 siguen yendo por delante. A cambio, los costes de API se disparan con el uso continuo. AMD calcula unos 774 dólares al mes en un escenario de uso intensivo. Más abajo, en el apartado de costes, explicamos de dónde sale esa cifra.
Nuestra recomendación: local o combinado
Editar y generar vídeos con IA
En la edición, la IA ya se encarga de muchas tareas pesadas: subtítulos automáticos, aislar voces o reescalar a 4K. Programas como CapCut, Topaz o las apps de Adobe usan para ello la gráfica y la NPU del ordenador. La NPU (Neural Processing Unit) es una unidad de cálculo diseñada para tareas de IA que consume muy poca energía.
No hay colas de subida y el material original se queda en tu propio SSD.
Generar es otra historia. Crear vídeos completos con IA o cientos de imágenes lleva mucho tiempo con una gráfica integrada. Los servicios en la nube son más rápidos y suelen dar mejor calidad.
Nuestra recomendación: editar en local, generar en la nube
Resumir, traducir y redactar correos
Resumir actas, traducir una oferta en inglés o preparar la respuesta a un cliente: es el día a día de la IA en muchas oficinas. Un modelo pequeño como Gemma 4 12B resuelve bien estas tareas rutinarias y ocupa solo unos 8 GB en la biblioteca de Ollama. Para textos exigentes o traducciones técnicas complicadas, ChatGPT o Gemini siguen siendo mejor opción.
En una empresa compensa combinar ambas, porque los documentos internos se quedan en el propio equipo. En cambio, si buscas una alternativa local a ChatGPT solo para preguntas personales de vez en cuando, te irá mejor con un servicio en la nube. El hardware propio solo sale a cuenta si lo usas con regularidad.
Nuestra recomendación: combinar ambas
Las siete tareas de un vistazo:
| Tarea | Modelo (ejemplo) | Recomendación |
|---|---|---|
| Agente de IA 24/7 | Modelo en la nube | Combinado |
| Consultar expedientes en un despacho o asesoría | De Gemma 4 31B a gpt-oss-120b | Local |
| Transcribir consultas médicas | Whisper + 27B a 35B | Local |
| Asistente de IA para el equipo | Qwen3.6-35B-A3B, Nemotron 3.5 Lightning | Local o combinado |
| Agente de programación | GLM-4.7-Flash, Qwen3.8-27B / Claude, GPT-6 | Local o combinado |
| Editar / generar vídeos | Funciones de GPU y NPU / nube | Local / nube |
| Resumir, traducir | Gemma 4 12B / ChatGPT, Gemini | Combinado |
¿De qué tamaño puede ser el modelo? Decide la RAM
Un modelo de lenguaje tiene que caber entero en la memoria mientras trabaja. El espacio que necesita depende de tres factores.
Parámetros: el número delante de la B indica los miles de millones de parámetros. Más parámetros suelen significar mejores respuestas, pero también más memoria.
Cuantización: consiste en guardar los valores del modelo con menos bits, normalmente 4 en lugar de 16. El modelo se reduce a una cuarta parte, más o menos, y la calidad apenas baja. Qwen3.8-27B ocupa así unos 18 GB, según Ollama.
MoE: un modelo Mixture of Experts se compone de muchas subredes especializadas, de las que solo unas pocas trabajan en cada token. En memoria están todos los parámetros, pero en velocidad se comporta más bien como un modelo pequeño.
Los ordenadores con memoria unificada tienen aquí ventaja. El procesador y la gráfica comparten la misma RAM, así que la gráfica puede usar mucha más memoria que en una tarjeta gráfica convencional. Eso es lo que permite ejecutar modelos grandes en un equipo compacto.
| Tamaño del modelo | Ejemplos actuales | RAM |
|---|---|---|
| 8B a 12B | Gemma 4 12B, Qwen3.5-9B | aprox. 16 GB |
| 14B a 27B | Qwen3.8-27B (4 bits), gpt-oss-20b | aprox. 32 GB |
| ~35B | Qwen3.6-35B-A3B, Gemma 4 31B | aprox. 64 GB |
| 70B a 130B | gpt-oss-120b, Mistral Medium 3.5 | 128 GB |
| Clase ≈180B* | Qwen3.8-Flash-Next | 128 GB |
Los valores son para modelos cuantizados. Que un modelo quepa o no depende además de su arquitectura, la cuantización, la longitud de contexto y el software. Los tamaños y las licencias figuran en la página de cada modelo.
* Suma de todos los componentes del modelo, con unos 6B parámetros activos por token; no es un modelo denso de 180B. Las mediciones están en el apartado de hardware.
Protección de datos y RGPD: qué pasa con tus datos
Con la IA en la nube, tus mensajes (los prompts) y tus archivos salen de la empresa. Lo importante es dónde los procesa el proveedor y si los usa para entrenar sus modelos. Para el uso profesional suele hacer falta un contrato de encargado del tratamiento según el artículo 28 del RGPD. La Agencia Española de Protección de Datos (AEPD) ha publicado además un decálogo de recomendaciones para proteger la privacidad al usar herramientas de IA.
También importa la ubicación. DeepSeek guarda los datos de sus usuarios en China, según su propia política de privacidad. En enero de 2025, el Garante italiano bloqueó la app en Italia y, ese mismo año, la autoridad de protección de datos de Berlín la denunció ante Apple y Google como contenido ilegal. Mistral, en cambio, aloja los datos por defecto en la UE, según la propia empresa.
En protección de datos, la IA local tiene una clara ventaja. Si un modelo abierto funciona sin conexión a la nube, los mensajes y los archivos no salen del equipo.
Eso no significa que la IA local cumpla automáticamente el RGPD. Siguen siendo obligatorios los permisos de acceso, el cifrado de los discos, por ejemplo con BitLocker, y el registro de la actividad.
A esto se suma el Reglamento europeo de IA (AI Act). Desde febrero de 2025, también las empresas que solo usan IA deben formar a su personal en competencias de IA. En julio de 2026 esta obligación se suavizó, pero sigue siendo recomendable documentar la formación. En España, la supervisión corresponde a la AESIA (Agencia Española de Supervisión de la Inteligencia Artificial). Las normas estrictas para los sistemas de alto riesgo independientes se aplicarán, según el Reglamento modificativo (UE) 2026/1744, a partir del 2 de diciembre de 2027.
Costes comparados: suscripción, precio por token y hardware propio
Para particulares, las suscripciones habituales cuestan unos 20 dólares o euros al mes. ChatGPT Plus y Claude Pro cuestan 20 dólares, y Google AI Pro, 21,99 euros. En las empresas se paga por usuario: unos 18 euros sin IVA por Microsoft 365 Copilot Business o, según la modalidad de pago, entre 25 y 30 dólares por ChatGPT Business.
Los agentes y las aplicaciones propias pagan a través de la API por tokens. Claude Sonnet 5.5 cuesta, según Anthropic, 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida, y GPT-6 Sol se mueve en cifras similares, según OpenAI.
AMD ha presentado un cálculo de ejemplo para un uso intensivo: unos 5,73 millones de tokens de entrada y 573.000 de salida al día, con unas ocho horas de trabajo intenso. Con los precios de API de Claude Sonnet 4.5 de entonces, salen 773,55 dólares al mes.
Frente a eso, AMD estima unos 16,20 dólares de electricidad para un ordenador local (150 W a 0,15 dólares por kWh), lo que equivale a tenerlo encendido las 24 horas. Con los precios actuales de Sonnet 5.5, la misma cantidad de tokens costaría unos 516 dólares. Ninguna de estas cifras incluye la compra del hardware.
¿Y en tu factura de la luz? Con un precio orientativo de 0,20 €/kWh, un equipo de 150 W encendido ocho horas al día gasta unos 7,20 euros al mes. Lo que consume de verdad un mini PC se puede estimar a partir de su TDP. Aun así, si solo usas la IA de vez en cuando, te sale mejor una suscripción que comprar hardware.
Qué hardware encaja con cada forma de usar la IA
Cada una de las tres formas de usar la IA plantea exigencias distintas al hardware.
Agente de IA: iX5 Max. Para un agente que funciona día y noche, lo importante es la resistencia y un consumo bajo. El iX5 Max, con Intel Core Ultra 5 125U, funciona a 20 W en modo silencioso e incluye dos puertos LAN de 2,5 Gbit/s y Wi-Fi 7. El software del agente se ejecuta en el equipo y el razonamiento corre a cargo de la nube, por ejemplo con ChatGPT, Claude o Gemini.
Nube + local: AX7 Max. El AX7 Max, con Ryzen AI 7 Pro 450, incorpora una NPU de 50 TOPS (billones de operaciones por segundo) para ejecutar funciones de IA en el propio equipo. La RAM DDR5 va en módulos SO-DIMM intercambiables y se puede ampliar; internamente se ha probado hasta 64 GB. Con 32 GB, según la tabla de memoria, funcionan modelos locales pequeños como Gemma 4 12B, y las tareas pesadas siguen yendo a la nube.
Totalmente local: AX9 Ultra. Para ejecutar modelos grandes sin conexión hace falta mucha memoria unificada. El AX9 Ultra monta el Ryzen AI Max+ 388 con gráficos Radeon 8060S y admite hasta 128 GB de LPDDR5X. Además, tiene dos puertos Ethernet y dos USB4. Con 64 GB funcionan muchos modelos de 35B y algunos de 70B; con 128 GB se puede cargar y ejecutar sin conexión incluso un modelo de la clase ≈180B, como Qwen3.8-Flash-Next.*
CUDA, el software de IA de Nvidia, no está disponible en estos equipos. La IA local funciona aquí con AMD ROCm o Vulkan, compatibles con llama.cpp, Ollama y LM Studio.
* ≈180B es la suma de los componentes de Qwen3.8-Flash-Next (125B de backbone, 51B de N-Gram y 4B de MTP), con unos 6B parámetros activos por token; no es un modelo denso de 180B. La base son 93,7 GB en UD-IQ4_XS más 2,78 GB de MTP en Q8_0. Se midieron 32,79 tokens/s en generación de texto con 131K de contexto, llama.cpp con Vulkan y MTP, en una plataforma de referencia con Ryzen AI Max+ 395 y 128 GB. Los resultados pueden variar.
Preguntas frecuentes sobre IA local y cloud
¿Es mejor la IA local o en la nube?
La IA local es mejor cuando la privacidad, el trabajo sin conexión o el uso frecuente son prioritarios. La nube es más sencilla para consultas ocasionales y ofrece acceso inmediato a modelos punteros. En muchas empresas, una estrategia híbrida aporta el mejor equilibrio.
¿Cuánta RAM hace falta para ejecutar IA en local?
Depende del modelo y de la cuantización. Como orientación, modelos de 8–12B pueden funcionar con unos 16 GB, modelos de 14–27B suelen requerir alrededor de 32 GB y las clases de 30–35B se benefician de unos 64 GB.
¿Necesito una gráfica NVIDIA?
No siempre. Ollama, llama.cpp y LM Studio pueden utilizar CPU, Vulkan y, en plataformas compatibles, ROCm. Sin embargo, algunos programas dependen específicamente de CUDA; conviene comprobar el software antes de comprar el equipo.
¿La IA local cumple automáticamente el RGPD?
No. Mantener los datos en el equipo reduce transferencias a terceros, pero siguen siendo necesarios permisos, cifrado, control de acceso, registros, copias de seguridad y una base jurídica adecuada para el tratamiento.
¿Cuándo compensa comprar hardware para IA local?
Cuando varias personas lo usan a diario, hay datos sensibles o se quiere evitar cuotas y límites de API. Para uso privado ocasional, una suscripción cloud suele ser más sencilla y evita la inversión inicial.
Conclusión
La IA local compensa cuando los datos confidenciales no deben salir de casa, cuando mucha gente la usa a diario o cuando quieres que los agentes funcionen sin límites de uso. La nube es mejor opción si necesitas los modelos más potentes, si quieres generar vídeos con IA o si solo la usas de vez en cuando. Y muchas veces lo más inteligente es combinarlas: el trabajo rutinario y sensible en local, y las tareas más exigentes, en la nube.

VZMORE es un fabricante líder de mini PC con IA. Nuestros sistemas combinan refrigeración VC silenciosa, gran potencia y capacidad de cómputo de IA inteligente, para aplicaciones exigentes en la oficina.
OFERTAS BLACK FRIDAY
15% DESCUENTO
OFERTA LIMITADA
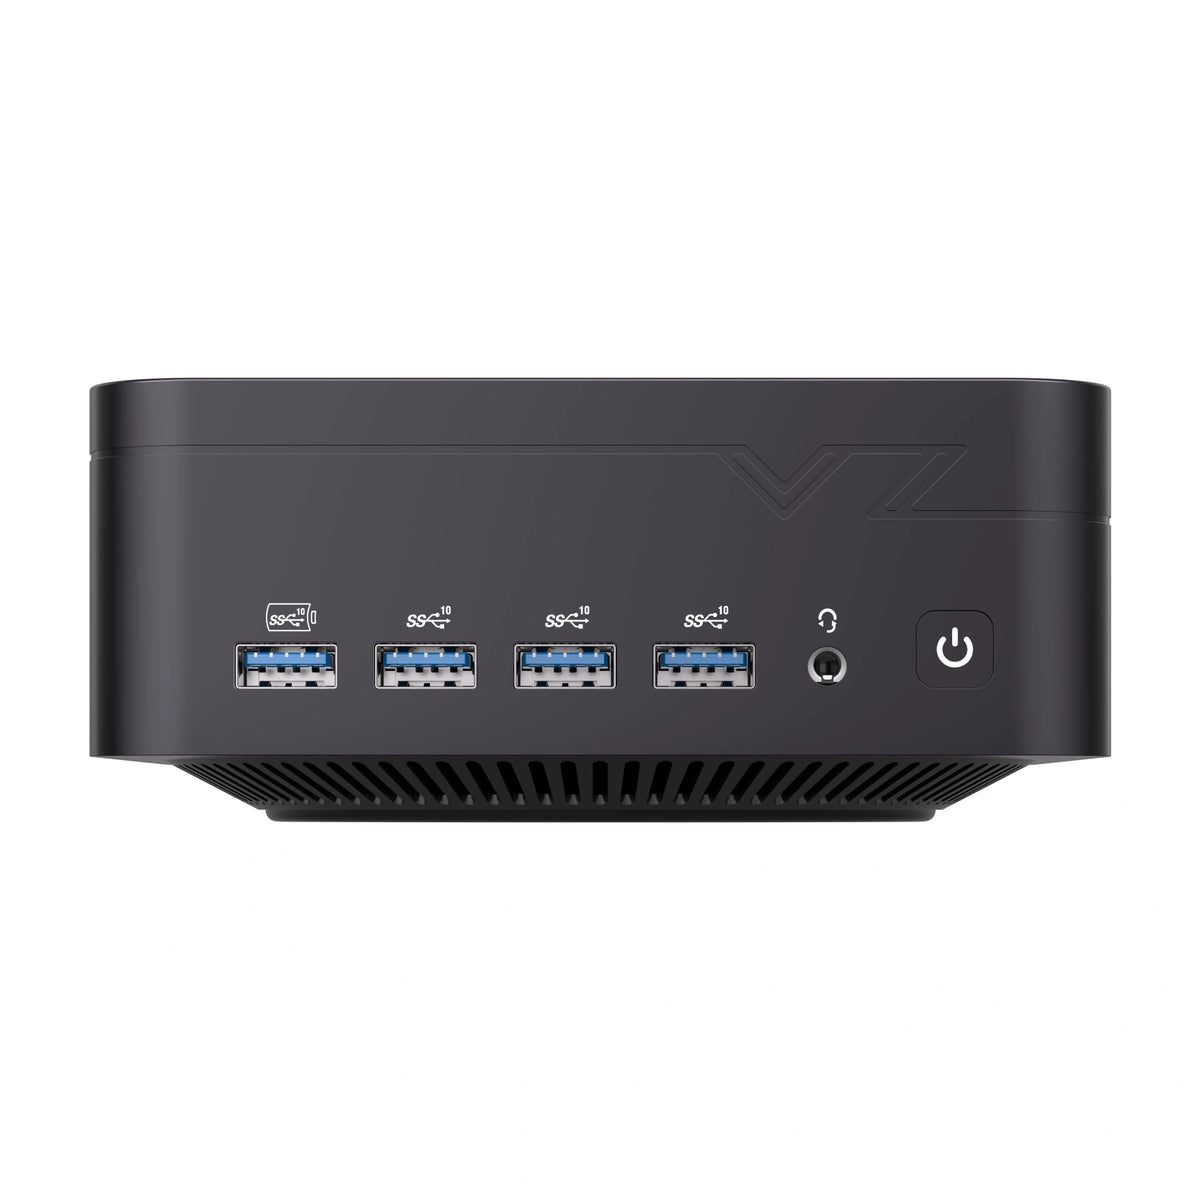
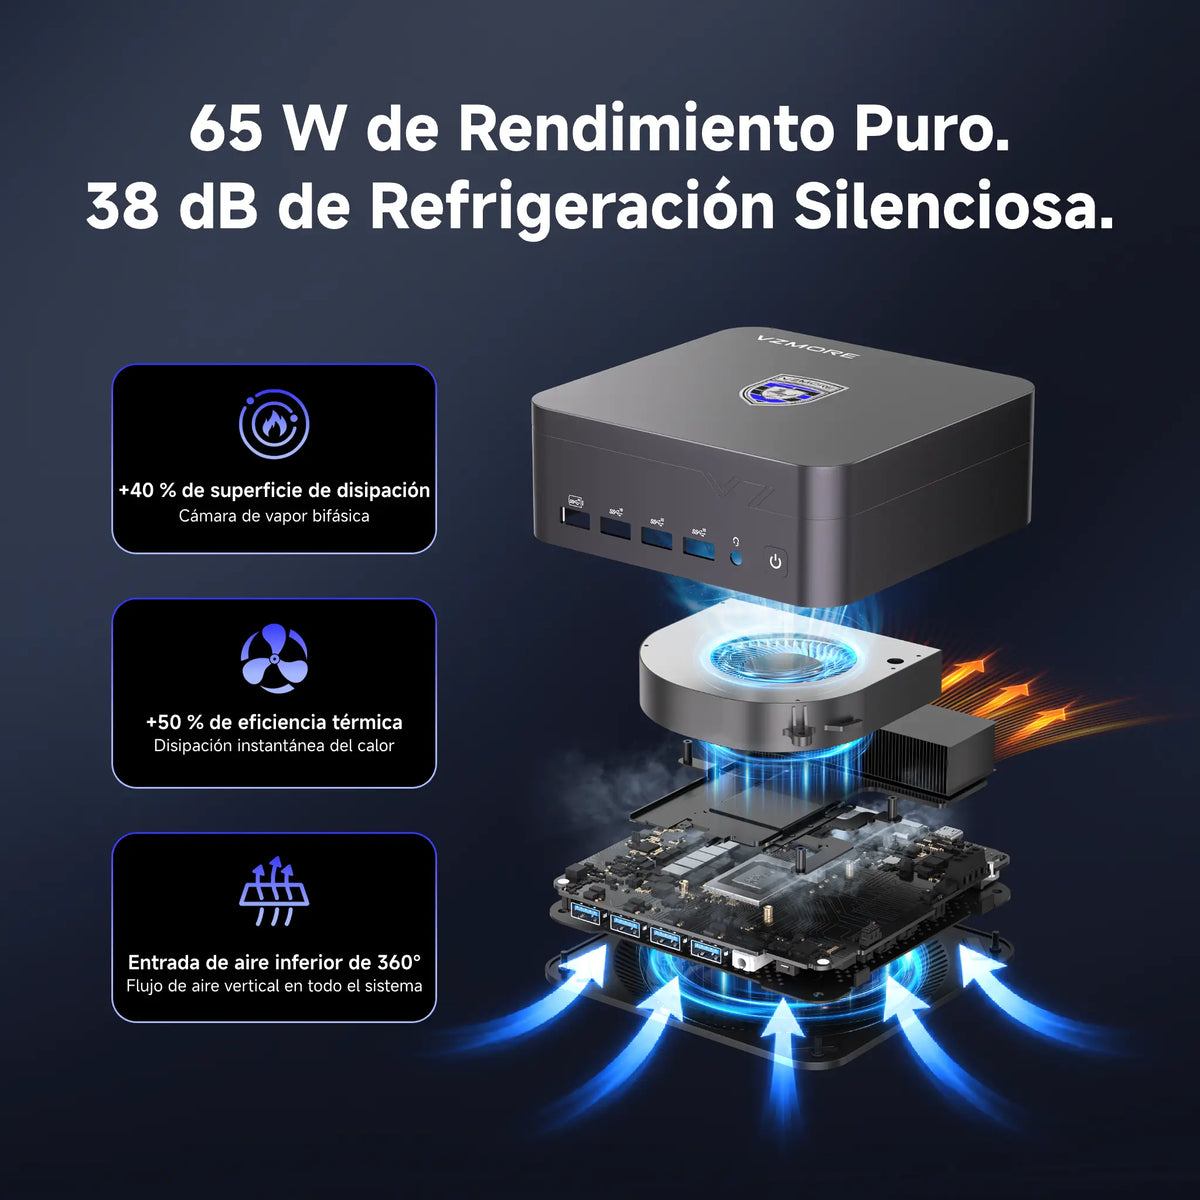
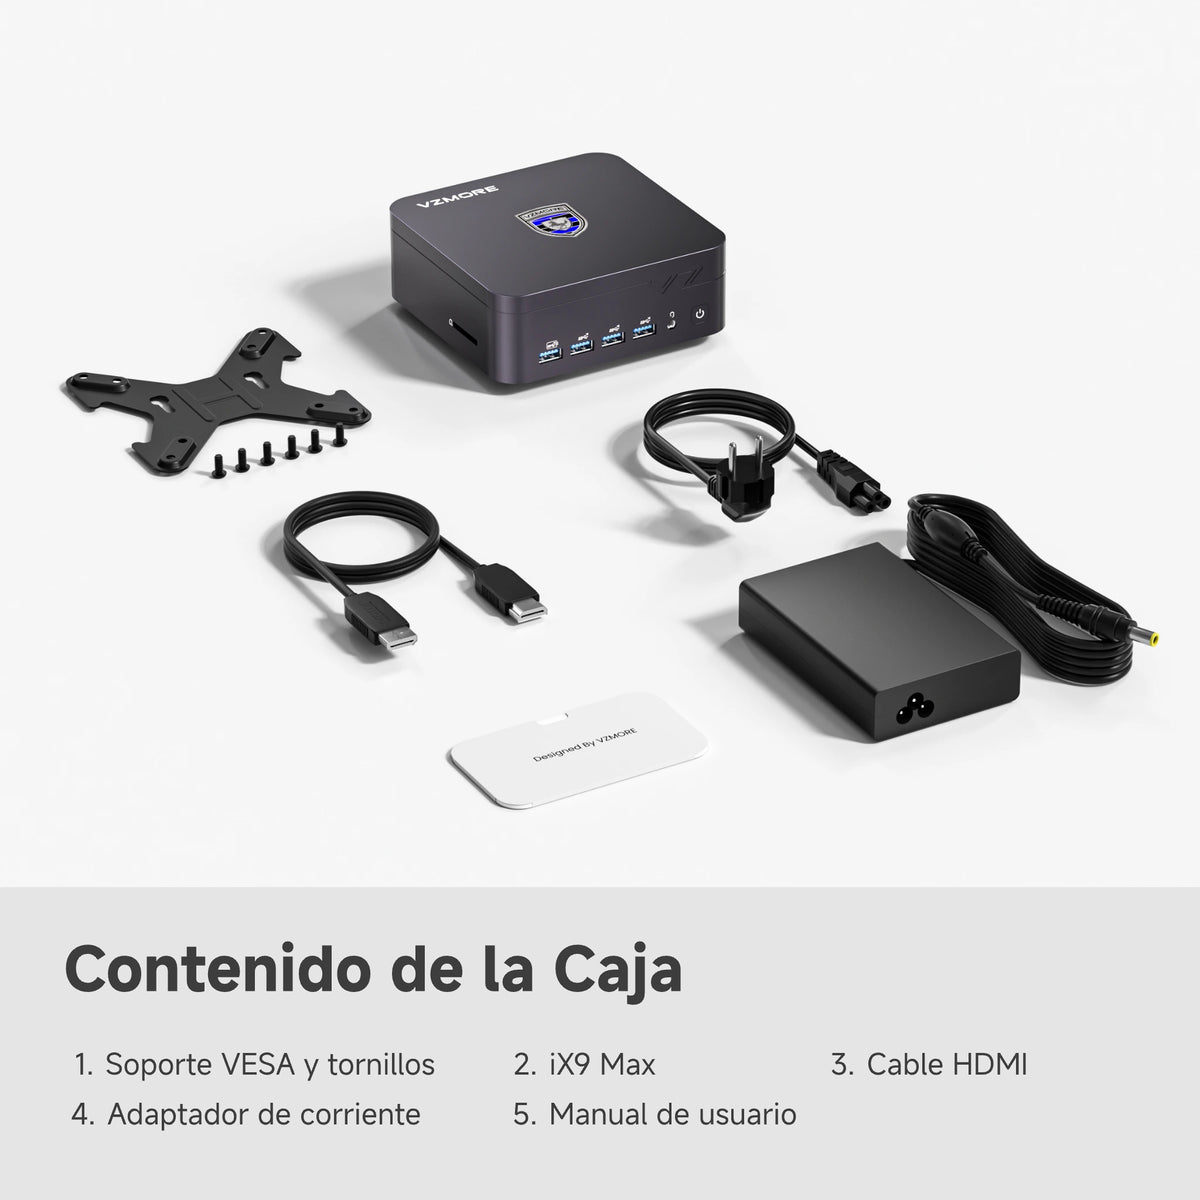
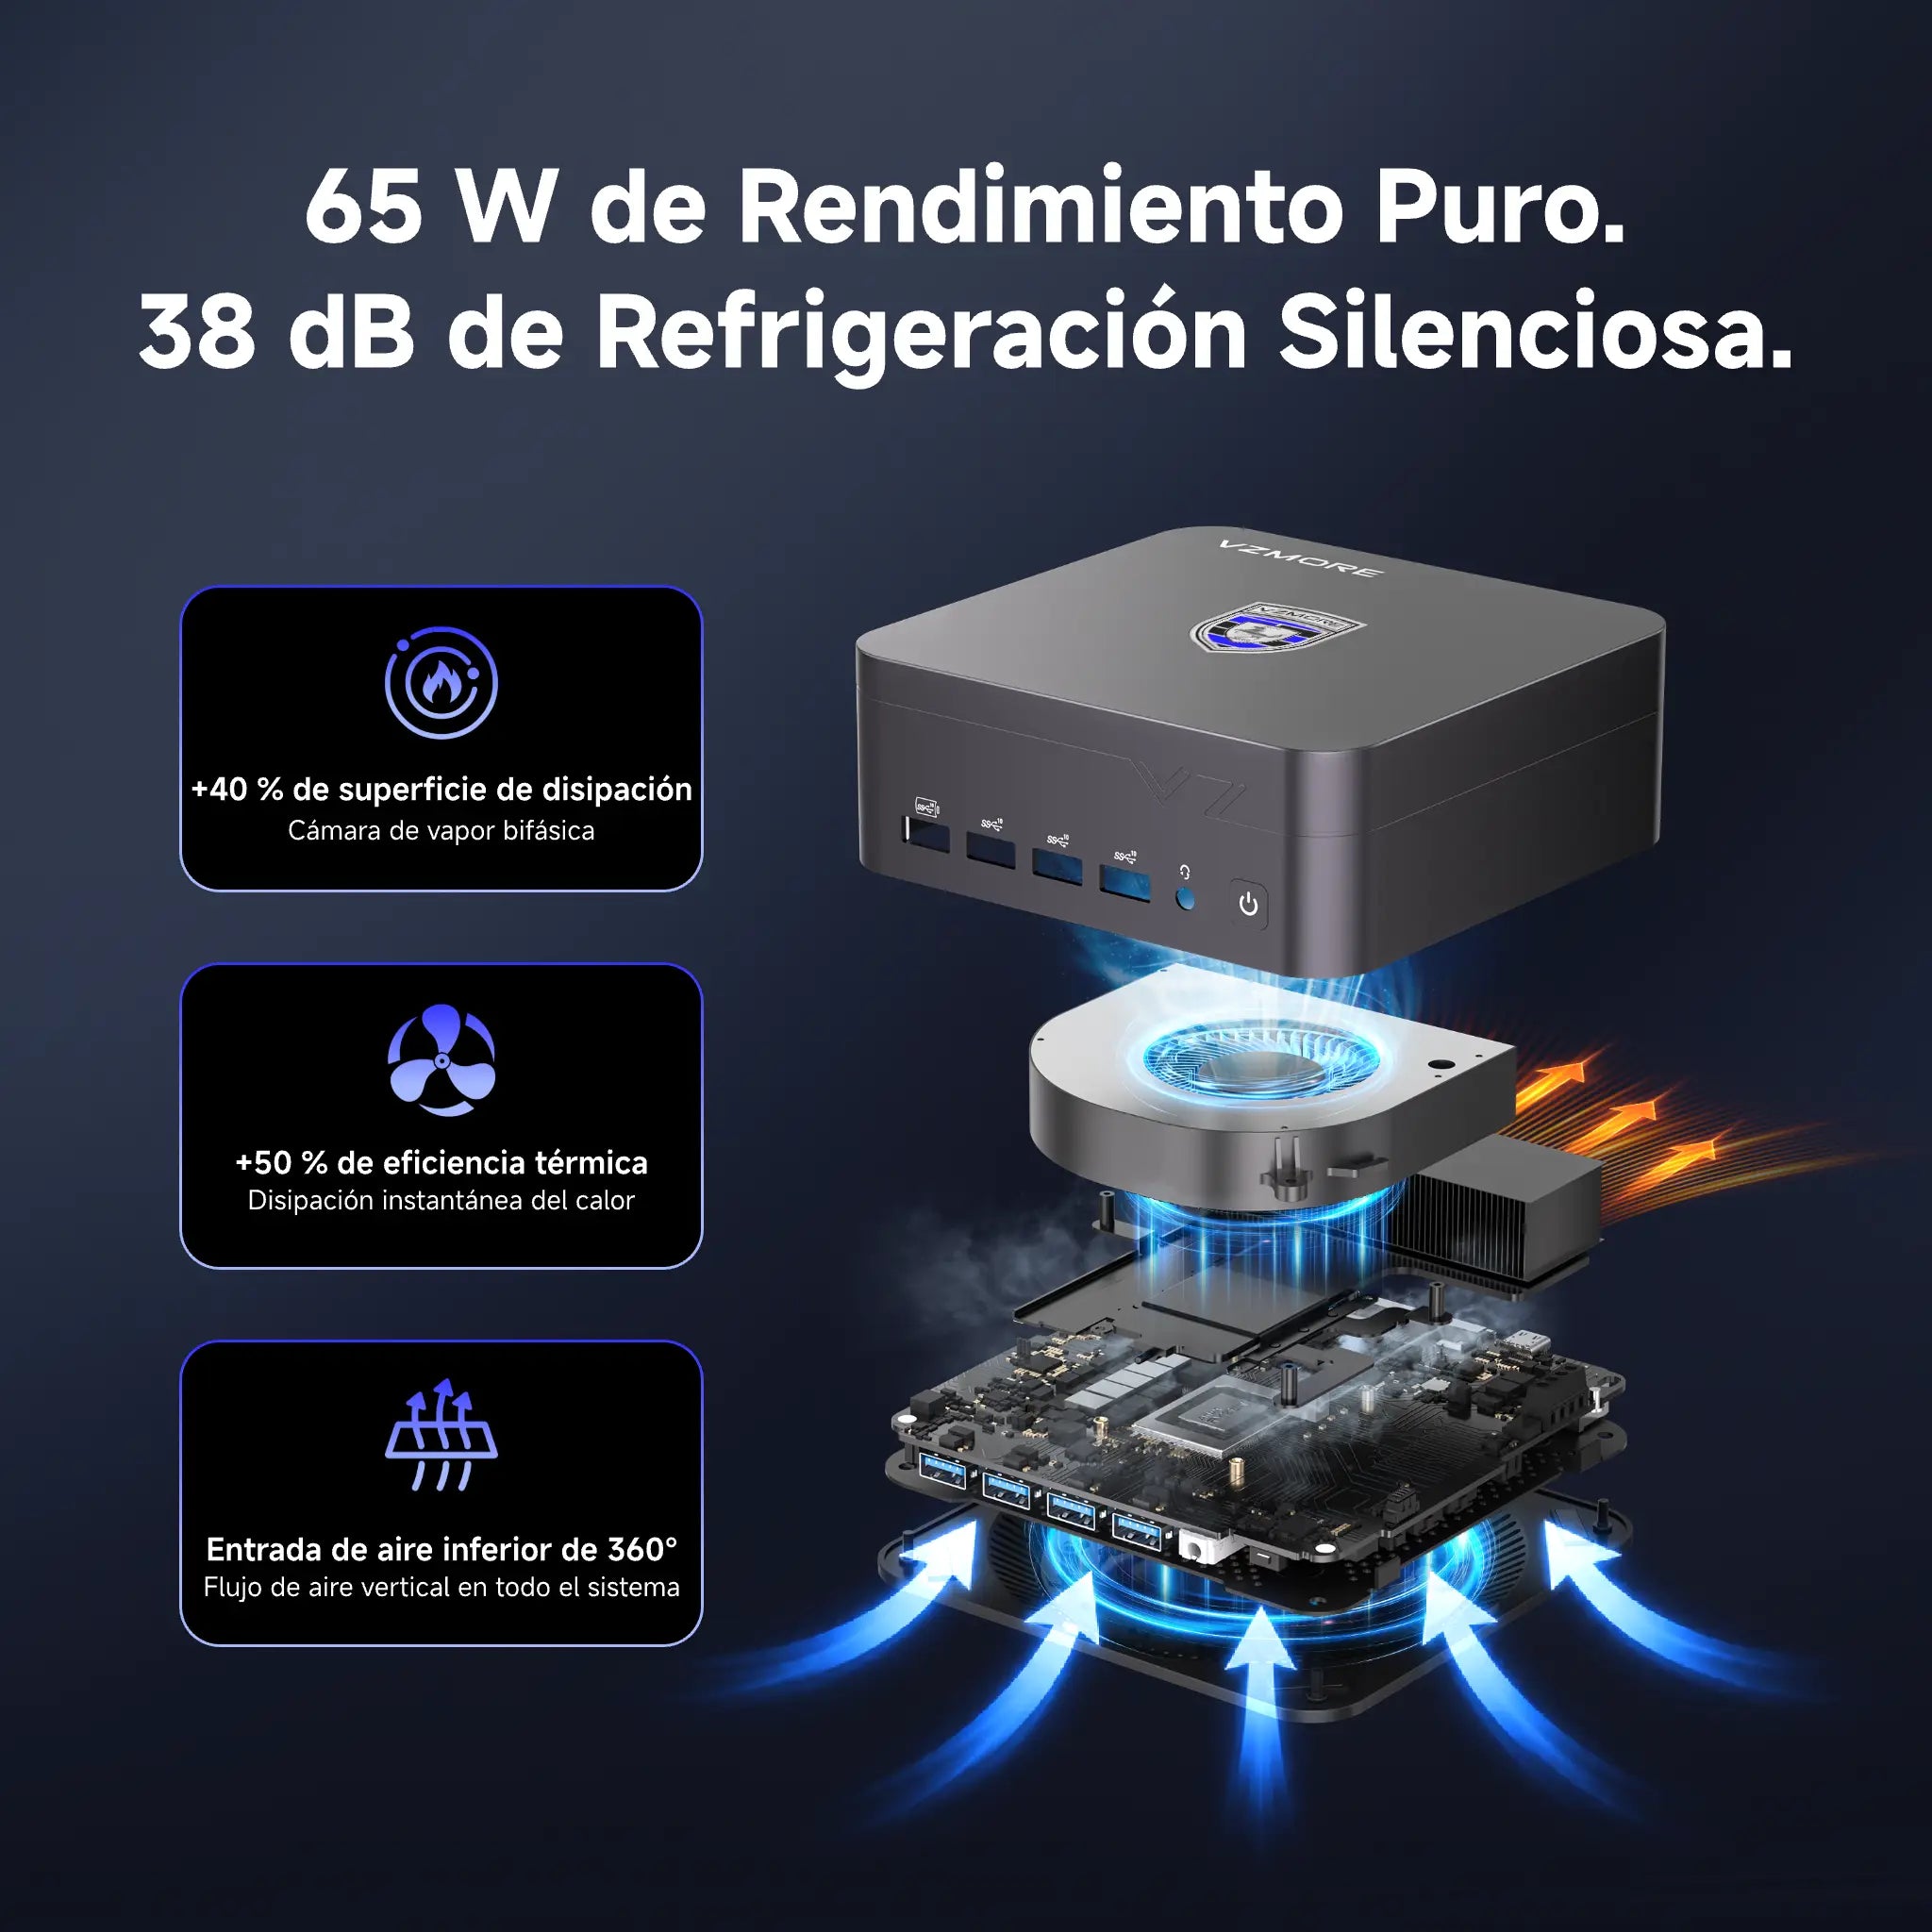
iX9 Max
Mini PC Intel Core Ultra 9 de nivel workstation
€849,15
€999
Más artículos
Suscríbete al boletín
Recibe novedades, actualizaciones de productos y ofertas exclusivas directamente en tu correo.